سیستم هوش مصنوعی و یادگیری عمیق
سیستم هوش مصنوعی کامپیوتری است که برای اجرای محلی مدلهای زبانی بزرگ (LLM)، تولید تصویر با Stable Diffusion و Flux، و آموزش و تنظیم دقیق (Fine-tuning) مدلهای یادگیری عمیق ساخته میشود. در اوستا آیتی سیستم هوش مصنوعی شما را بر اساس اندازهی مدلهایی که میخواهید اجرا کنید، حجم دادهها و بودجهتان پیکربندی، اسمبل و پیش از تحویل زیر بار سنگین تست میکنیم.
چرا سیستم هوش مصنوعی شخصی؟
حریم خصوصی دادهها
با اجرای محلی مدلها، اسناد، کدها و دادههای مشتریان شما هرگز از سیستم خودتان خارج نمیشوند. برای شرکتها، دفاتر حقوقی و پزشکی و هر کسبوکاری که با اطلاعات حساس کار میکند، این مهمترین مزیت است.
بدون محدودیت و تحریم
سیستم محلی به اشتراک ماهانه، محدودیت تعداد درخواست یا دسترسی به سرویسهای خارجی وابسته نیست. مدلهای متنباز مثل Llama، Qwen، DeepSeek و Mistral را هر زمان و به هر تعداد که بخواهید اجرا میکنید.
آموزش و شخصیسازی
برای پژوهشگران، دانشجویان و توسعهدهندگان، سیستم شخصی امکان آزمایش سریع، آموزش مدلهای کوچک و تنظیم دقیق مدلهای بزرگ با روشهایی مثل LoRA را روی دادههای خودتان فراهم میکند.
چه مدلی روی سیستم شما اجرا میشود؟
در هوش مصنوعی، مهمترین مشخصهی سیستم حافظهی گرافیکی (VRAM) است. مدل باید در حافظهی کارت گرافیک جا شود؛ در غیر این صورت بخشی از آن به رم سیستم منتقل میشود و سرعت چند برابر افت میکند. جدول زیر نیاز تقریبی مدلهای رایج را نشان میدهد:
| مدل / کاربرد | حافظهی تقریبی مورد نیاز | کارت گرافیک مناسب |
|---|---|---|
| LLM با ۷ تا ۸ میلیارد پارامتر (کوانتیزه ۴ بیتی) | حدود ۶ گیگابایت | کارت ۱۲ گیگابایتی به بالا |
| LLM با ۱۳ تا ۱۴ میلیارد پارامتر (۴ بیتی) | حدود ۱۰ گیگابایت | RTX 5070 Ti / 5080 (۱۶GB) |
| LLM با ۳۰ تا ۳۲ میلیارد پارامتر (۴ بیتی) | حدود ۲۰ گیگابایت | RTX 5090 (۳۲GB) |
| LLM با ۷۰ میلیارد پارامتر (۴ بیتی) | حدود ۴۰ گیگابایت | دو کارت RTX 5090 (۶۴GB) |
| Stable Diffusion XL | ۸ تا ۱۲ گیگابایت | کارت ۱۲ تا ۱۶ گیگابایتی |
| Flux و ویدیوسازی هوش مصنوعی | ۱۶ تا ۲۴ گیگابایت به بالا | RTX 5090 (۳۲GB) |
| تنظیم دقیق (LoRA) مدلهای ۷ تا ۸ میلیاردی | ۱۶ تا ۲۴ گیگابایت | RTX 5080 تا RTX 5090 |
راهنمای انتخاب قطعات سیستم هوش مصنوعی
کارت گرافیک NVIDIA
تقریباً تمام ابزارهای هوش مصنوعی مثل PyTorch، TensorFlow، vLLM و ComfyUI بر پایهی CUDA انویدیا ساخته و بهینه شدهاند. کارتهای سری RTX 50 با هستههای Tensor نسل جدید و پشتیبانی از FP4 انتخاب اصلی هستند. RTX 5090 با ۳۲ گیگابایت حافظه قدرتمندترین کارت دسکتاپ برای هوش مصنوعی است.
کارتهای AMD و هوش مصنوعی
پشتیبانی AMD از هوش مصنوعی از طریق پلتفرم ROCm در حال گسترش است و ابزارهایی مثل Ollama و llama.cpp روی کارتهای Radeon هم اجرا میشوند. با این حال اکوسیستم انویدیا بسیار بالغتر است و برای کار حرفهای و پژوهشی، کارتهای NVIDIA را پیشنهاد میکنیم.
رم سیستم
رم سیستم باید حداقل برابر و ترجیحاً دو برابر حافظهی گرافیکی باشد تا بارگذاری مدلها و پردازش دادهها روان انجام شود. برای سیستمهای تککارته ۶۴ گیگابایت و برای سیستمهای حرفهای ۱۲۸ گیگابایت رم DDR5 توصیه میشود.
حافظهی SSD پرحجم
هر مدل زبانی بزرگ دهها گیگابایت حجم دارد و دیتاستها از آن هم بزرگترند. SSD نوع NVMe با ظرفیت ۲ ترابایت به بالا، زمان بارگذاری مدلها را به چند ثانیه کاهش میدهد.
پردازنده
در اجرای مدلها بار اصلی روی کارت گرافیک است، اما پیشپردازش دادهها، بارگذاری دیتاست و اجرای بخشی از مدل در صورت کمبود VRAM به پردازندهی قوی نیاز دارد. Ryzen 9 با ۱۲ تا ۱۶ هسته انتخاب متعادلی است.
پاور و خنککاری برای بار مداوم
آموزش مدل یعنی ساعتها و گاهی روزها بار کامل روی کارت گرافیک. RTX 5090 به تنهایی تا حدود ۵۷۵ وات مصرف دارد؛ برای سیستم تککارته پاور ۱۲۰۰ وات و برای سیستم دو کارته پاور ۱۶۰۰ وات با راندمان Platinum یا Titanium لازم است.
پیکربندیهای پیشنهادی سیستم هوش مصنوعی
تمام قطعات از موجودی فروشگاه اوستا آیتی انتخاب شدهاند و هر قطعه بر اساس مدلها و بودجهی شما قابل تغییر است. مادربرد، کیس و خنککننده در مشاوره انتخاب میشوند. به دلیل نوسان بازار، قیمت روز را از کارشناسان ما استعلام کنید.
سیستم هوش مصنوعی ۱۶ گیگابایتی
اجرای LLMهای تا ۱۴ میلیارد پارامتر، Stable Diffusion XL و یادگیری
 پردازنده ایامدیپردازنده ایامدی Ryzen 9 9900X Trayاستعلام قیمت
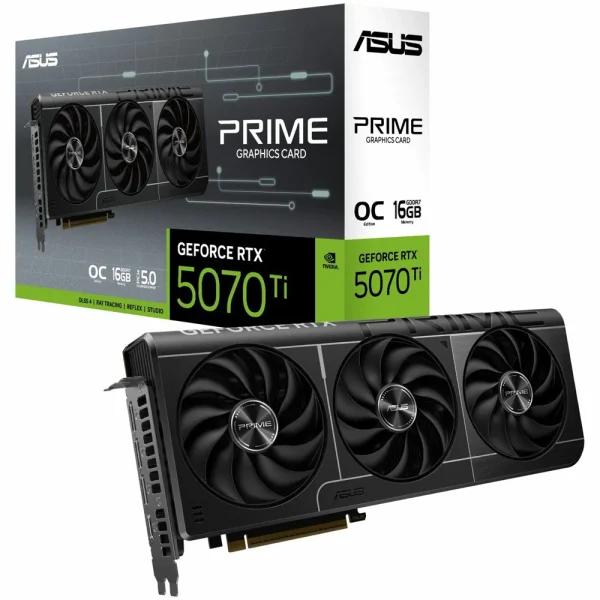
 کارت گرافیک انویدیاکارت گرافیک ASUS Prime GeForce RTX 5070 Ti OC Edition 16GB GDDR7استعلام قیمت
 رم DDR5رم کورسیر RGB 32GB×2 DDR5-6400استعلام قیمت
 اساسدی M.2 NVMeاساسدی اینترنال WD Blue SN5100 ظرفیت 2 ترابایت NVMe65,979,500 تومان
 منبع تغذیهپاور کامپیوتر اماسآی MAG A850GL PCIE5 850 وات Gold (مشکی)استعلام قیمت
سیستم هوش مصنوعی RTX 5090
مدلهای تا ۳۲ میلیارد پارامتر، Flux، ویدیوسازی و تنظیم دقیق با LoRA
- پردازنده ایامدیپردازنده ایامدی Ryzen 9 9950X Boxاستعلام قیمت
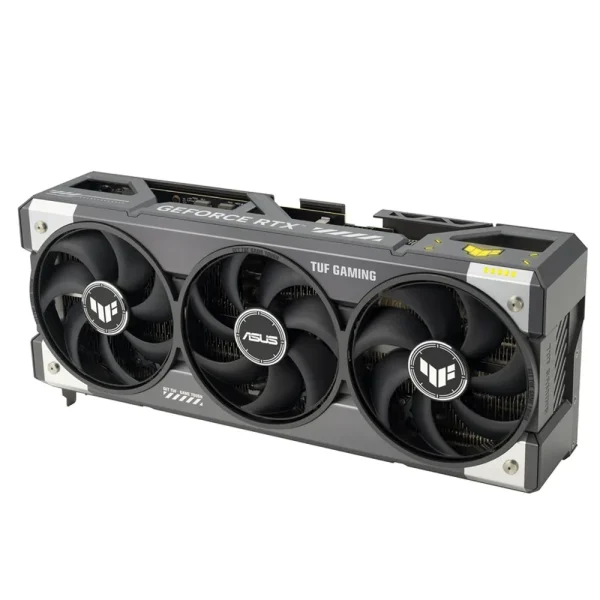
 کارت گرافیک انویدیاکارت گرافیک ASUS TUF Gaming GeForce RTX 5090 OC Edition 32GB GDDR7استعلام قیمت
- رم DDR5رم کورسیر RGB 32GB×2 DDR5-6400استعلام قیمت
 اساسدی M.2 NVMeاساسدی سامسونگ 990 PRO ظرفیت 2 ترابایتاستعلام قیمت
 منبع تغذیهپاور کامپیوتر ایسوس ROG Strix 1200W Gold Aura Editionاستعلام قیمت
سیستم دو کارته ۶۴ گیگابایتی
دو عدد RTX 5090؛ اجرای مدلهای ۷۰ میلیاردی و آموزش سنگین
- پردازنده ایامدیپردازنده ایامدی Ryzen 9 9950X Boxاستعلام قیمت
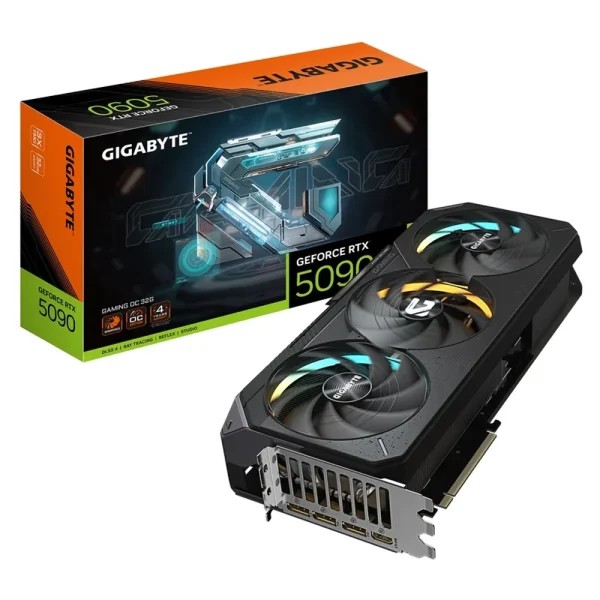
 کارت گرافیک انویدیاکارت گرافیک Gigabyte GeForce RTX 5090 WINDFORCE 3X OC 32GB GDDR7استعلام قیمت
- رم DDR5رم کورسیر RGB 32GB×2 DDR5-6400استعلام قیمت
 اساسدی M.2 NVMeاساسدی سامسونگ 990 PRO با هیتسینک ظرفیت 2 ترابایتاستعلام قیمت
 منبع تغذیهپاور کامپیوتر اماسآی MEG Ai1600T PCIE5 1600 وات Titaniumاستعلام قیمت
کاربردهای سیستم هوش مصنوعی
اجرای مدلهای زبانی (LLM) بهصورت محلی
با ابزارهایی مثل Ollama و LM Studio میتوانید مدلهای متنباز را روی سیستم خودتان اجرا کنید؛ برای چت، خلاصهسازی اسناد، ترجمه، برنامهنویسی و ساخت دستیار اختصاصی سازمان با دادههای خودتان (RAG).
تولید تصویر و ویدیو
Stable Diffusion، Flux و ComfyUI برای طراحان، عکاسان و تولیدکنندگان محتوا؛ هرچه حافظهی گرافیکی بیشتر باشد، تصاویر با وضوح بالاتر و مدلهای سنگینتر سریعتر تولید میشوند.
پژوهش و آموزش مدل
برای دانشجویان تحصیلات تکمیلی و پژوهشگران، آموزش مدلهای بینایی ماشین، پردازش زبان طبیعی و تنظیم دقیق مدلهای بزرگ روی سیستم شخصی، بدون صف و هزینهی سرورهای ابری.
کاربردهای ترکیبی
اگر علاوه بر هوش مصنوعی، رندر سهبعدی یا بازی هم انجام میدهید، کارتهای RTX 50 هر سه کار را بهخوبی پوشش میدهند. صفحههای سیستم رندرینگ و سیستم گیمینگ را هم ببینید.
مراحل ساخت سیستم هوش مصنوعی در اوستا آیتی
- ۱
نیازسنجی رایگان
مدلها، کاربرد، حجم دادهها و بودجهی شما را بررسی میکنیم.
- ۲
انتخاب قطعات
تعیین حافظهی گرافیکی لازم و کنترل سازگاری قطعات.
- ۳
اسمبل حرفهای
مونتاژ دقیق با جریان هوای مناسب بار مداوم.
- ۴
استرستست
تست پایداری زیر بار کامل کارت گرافیک و کنترل دما.
- ۵
تحویل و پشتیبانی
تحویل حضوری در تهران یا ارسال به سراسر کشور.
سوالات متداول دربارهی سیستم هوش مصنوعی
بهترین کارت گرافیک برای هوش مصنوعی کدام است؟
برای اجرای LLM بهصورت محلی چقدر حافظهی گرافیکی لازم است؟
آیا کارت گرافیک AMD برای هوش مصنوعی مناسب است؟
آیا میتوان مدلهای ۷۰ میلیارد پارامتری را روی سیستم شخصی اجرا کرد؟
برای سیستم هوش مصنوعی چقدر رم لازم است؟
آیا با این سیستمها میتوان مدل آموزش داد؟
مشاورهی رایگان خرید سیستم هوش مصنوعی
بگویید چه مدلهایی میخواهید اجرا کنید؛ کارشناسان اوستا آیتی بهترین پیکربندی را برایتان پیشنهاد میدهند.
مراجعهی حضوری: تهران، چهارراه ولیعصر، پاساژ ابریشم، طبقهی همکف، واحد ۲۰ — شنبه تا پنجشنبه ۱۰:۳۰ تا ۱۹